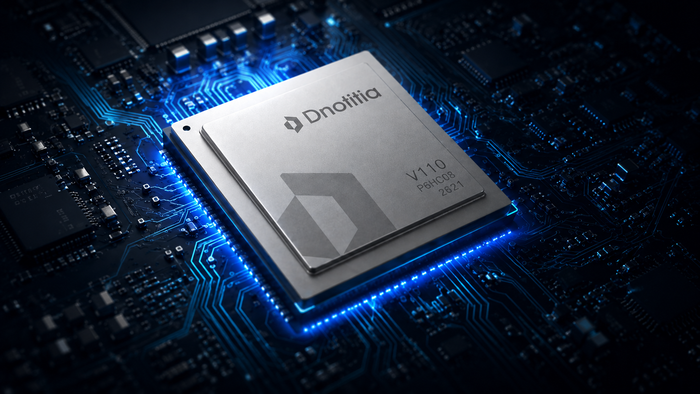
생성형 인공지능(AI) 경쟁이 거대언어모델(LLM)을 넘어, 기업 내부 데이터에서 얼마나 빠르고 정확하게 학습하고 추론하는가로 옮겨가고 있다. 검색증강생성(RAG)과 AI 에이전트 기술을 기반으로 문서·이미지·표·코드 등을 의미 단위로 탐색하는 벡터 검색이 AI 서비스 핵심 인프라로 떠오른 것이다. 디노티시아는 '벡터 데이터 처리 전용 반도체(VDPU)'로 이 수요를 정조준했다.
VDPU는 각종 데이터를 벡터로 전환 유사성을 비교하는 벡터DB 연산을 가속화하도록 설계됐다. 지금까지 벡터DB 시장은 파인콘·위비에이트·밀버스 등 소프트웨어 플랫폼이 주도했고, 실제 검색 연산은 범용 중앙처리장치(CPU)나 그래픽처리장치(GPU)가 맡았다.
그러나 대규모 RAG 환경에서는 검색 대상 벡터가 수억~수십억 개로 늘어나고, AI 에이전트가 한 번의 답변을 위해 여러 차례 검색을 반복하면서 CPU 자원 소모, GPU 메모리 부족, 스토리지와 연산 장치 사이 데이터 이동이 새로운 병목으로 떠오른다.
디노티시아 VDPU는 검색 연산을 저장된 데이터 가까이에서 처리하는 것이 목표다. 기존 벡터 검색을 맡아왔던 CPU·GPU 부담과 불필요한 데이터 이동을 낮추는 구조다. 대표적인 AI 반도체인 신경망처리장치(NPU)와도 비교된다. NPU가 AI의 '두뇌 연산'을 담당한다면 VDPU는 AI '기억 검색'에 최적화했다.
회사는 자체 벡터DB·AI 스토리지 솔루션 '씨홀스'와 VDPU를 하드웨어·소프트웨어 공동 설계 방식으로 결합하고 있다. 궁극적으로는 데이터 전처리, 색인, 저장, 검색, AI 서비스 연계를 하나의 AI 스토리지 플랫폼으로 묶겠다는 구상이다.
디노티시아는 VDPU와 벡터DB, 기업용 RAG 운영 소프트웨어를 함께 제공하는 수직통합 모델을 내세운다. 범용 GPU와 직접 성능 경쟁을 벌이기보다, GPU가 답변 생성에 집중하도록 하고 VDPU가 '필요한 지식 찾기'를 맡도록 역할을 분리하겠다는 전략이다.
양산 로드맵도 구체화되고 있다. 디노티시아는 VDPU 샘플 칩 제작을 마치고 내부 최적화 및 성능 평가를 진행 중이다. 이르면 올해 말 양산에 착수할 계획이다.
지난 8월 미국 세계 최대 메모리·스토리지·AI 인프라 기술 행사인 FMS 2026에서는 첫 VDPU 칩을 탑재한 벡터 검색 가속기 카드를 공개하고, 글로벌 스토리지 업체 및 AI 인프라 기업과 제품 통합·공동개발·개념검증(PoC) 협력을 추진하고 있다.
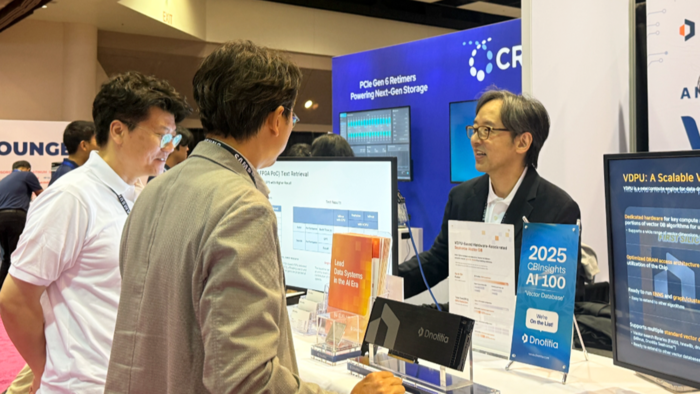
정무경 디노티시아 대표는 “디노티시아는 칩이나 소프트웨어를 하나씩 파는 일이 아니라, 기업이 데이터를 저장하고 찾고 활용하는 전 과정을 책임지는 AI 데이터 인프라를 만드는 일”이라며 ““씨홀스와 VDPU를 결합한 AI 스토리지는 그 출발점으로 이 기술이 놓이는 환경, 즉 데이터가 머물고 운영되는 공간 전체로 역할을 넓혀 가겠다”고 밝혔다.
권동준 기자 djkwon@etnews.com