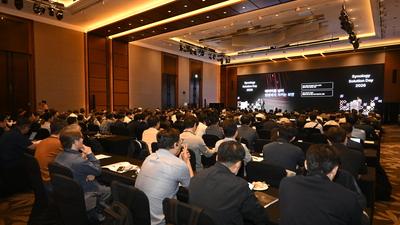
SK하이닉스가 인공지능 시대에 맞춰 고대역폭메모리(HBM)부터 대용량 스토리지까지 아우르는 '풀스택 AI 메모리 크리에이터'를 지향한다고 밝혔다. 모델이 커지고 에이전틱 인공지능이 확산되면서 메모리 수요가 계속 늘어나, 단일 제품이 아니라 계층별 솔루션이 필요하다는 판단이다.
임의철 SK하이닉스 솔루션 어드밴스드 테크놀로지 담당 부사장은 29일 전자신문 '테크서밋 2026'에서 “프로세서 성능은 빠르게 올랐지만 메모리는 상대적으로 더뎌 '메모리 월'이 여전하다”며 “이제는 하나의 메모리(HBM)만으로는 AI 워크로드를 커버하기 어려워졌다”라고 강조했다.
대규모 언어모델 추론에서 입력 이해 단계(프리필)는 그래픽처리장치(GPU) 연산 중심이지만, 답변을 한 토큰씩 생성하는 단계(디코딩)는 모델 가중치를 반복해서 읽어야 해 메모리 대역폭에 성능이 크게 좌우된다. 고성능 GPU를 사용해도 한계가 있는 것이다.
대역폭만이 문제가 아니다. 모델 크기가 커지면서 용량도 동시에 필요하다. S램 기반 가속기는 대역폭은 높아 퍼포먼스 기대치가 높지만 용량 확보가 어려운 문제가 있다. 초기 챗GPT급 모델만 해도 요구 용량이 350기가바이트(GB)에 달해 웨이퍼 여러 장과 칩 수백 개가 필요하다.
현 시점에서는 고대역폭과 대용량을 같이 맞추기 위해 HBM이 필수 구성 요소가 됐다. 메모리 다이를 쌓아 단위 면적당 용량을 증가시키고, 입출력(I/O) 핀 숫자를 늘려 메모리 대역폭을 낮은 파워로도 가능하게 했다.
토큰 수요도 급격히 늘고 있다. 추론형 모델과 에이전틱 인공지능은 기존 대비 출력 토큰을 수백 배까지 늘린다. 용량은 토큰 수에 비례해 늘고, 연산과 대역폭 요구는 그보다 더 가파르게 증가한다. 알고리즘이 토큰당 활성 메모리를 줄이거나 이미 계산된 상태를 재사용하면 단위 비용은 낮아지지만, 더 긴 문맥과 더 많은 동시 요청이 가능해져 총 메모리 트래픽은 오히려 늘어난다.
에이전틱 인공지능은 이 수요를 구조적으로 키운다. 기존 챗봇은 사람이 입력할 때만 자원을 썼지만, 에이전트는 작업을 위임받으면 도구와 다른 에이전트와 상호작용하며 24시간 계속 동작한다.
SK하이닉스는 활성 데이터(모델 가중치 중 자주 쓰이는 부분)는 HBM에, 대용량·웜 데이터(용량은 크지만 항상 읽을 필요는 없는 데이터)는 HBF에, 더 빈도가 낮은 데이터는 CXL 풀드 메모리와 SSD로 나누는 계층형 라인업을 구축하고 있다. 자주 쓰는 건 빠른 메모리에, 용량이 큰 건 중간 계층에, 가끔 쓰는 건 더 싼 저장장치에 나눠 넣는다는 전략이다.
메모리 안에서 연산을 일부 처리하는 PIM(Processing-In-Memory)도 풀스택 메모리 라인업 중 하나다. HBF가 용량을 넓히는 축이라면, PIM은 대역폭을 끌어올리는 기술이다.
일반 구조에서는 데이터를 메모리에서 꺼내 프로세서(GPU·CPU)로 보내 계산한 뒤 다시 메모리에 저장한다. 이 과정에서 데이터가 많이 움직여 대역폭과 전력 부담이 커진다. PIM은 계산 일부를 메모리 칩 안에서 직접 수행해, 데이터가 움직이는 양을 줄이고 실효 대역폭을 높이려는 접근이다.
임의철 부사장은 “소프트웨어 효율만으로는 부족하고 하드웨어 혁신이 필요하다”며 “풀스택 메모리 솔루션으로 인공지능을 더 확장 가능하고 접근 가능하게 만들겠다”고 말했다.
이형두 기자 dudu@etnews.com