케이던스가 기존 대비 1.5배 빠른 'HBM4·HBM4E'용 메모리 인터페이스(연결) 설계자산(IP)을 개발했다. 인공지능(AI) 가속기 시스템온칩(SoC)과 메모리 간 연결 성능을 대폭 끌어올려 '병목' 해소에 나선다.
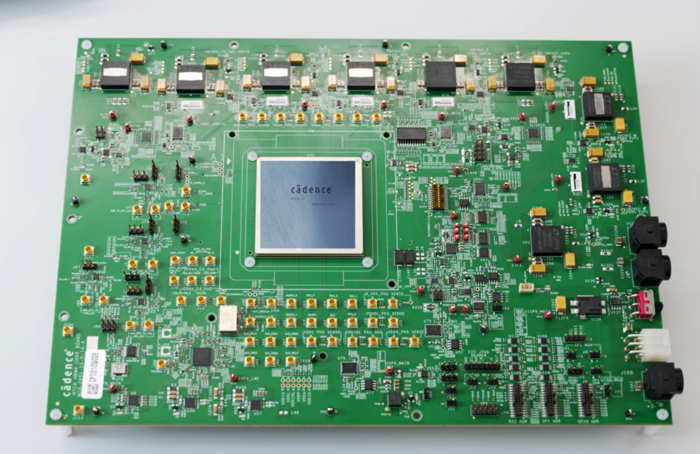
16일 업계에 따르면, 미국 반도체 IP 및 설계자동화(EDA) 기업인 케이던스는 최근 3나노미터(㎚) 첨단 공정 기반 HBM4·HBM4E 메모리 서브시스템 IP를 개발했다. 시제품을 통한 성능 검증에도 성공했다.
메모리 서브시스템은 SoC와 메모리 간 연결을 담당하는 '파이(PHY)'를 비롯, 컨트롤러, 인터커넥트 등 구성 요소를 의미한다. AI 가속기 경우 GPU와 HBM이 서로 신호를 주고 받기 위한 각종 기능을 이 메모리 서브시스템에서 담당한다.
케이던스가 개발한 IP는 핀당 전송 속도가 14Gbps를 달성했다. 기존 주력 메모리인 HBM3E 최고 전송속도가 핀당 8~9.6Gbps 수준이었던과 견줘 1.5배 빨라졌다.
케이던스 관계자는 “케이던스 랩 스테이션 환경에서 진행된 실시간 메모리 트래픽 테스트 결과, 컨트롤러부터 D램까지 이어지는 왕복 구간에서 14Gbps 속도로 단 한건의 오류없이 완벽한 동작을 확인했다”고 밝혔다.
나아가 송신기(TX) 성능 테스트에서는 현재 확정된 HBM4 표준 규격 최고 속도인 16Gbps를 달성했다. 메모리 서브시스템 한계 성능을 시험하는 스트레스 테스트에서는 18Gbps의 초고속 대역에서도 신호 무결성을 유지한 것으로 나타났다.
케이던스는 데이터 전송 시 발생하기 쉬운 신호 왜곡과 전력 손실을 방지하기 위해 독자적인 인터포저 설계 기술도 함께 적용했다. 인터포저는 신호 무결성(SI) 및 전력 무결성(PI) 검증을 완료했으며, HBM 파이 라이선스 고객사가 자사 AI SoC 인터포저 설계에 즉시 적용할 수 있도록 제공된다.
케이던스 측은 “이번 메모리 서브시스템은 AI SoC 개발사들에 더 높은 생산 수율과 신뢰성을 보장한다”며 “글로벌 반도체 기업들이 메모리 벽을 허물고 최상의 AI 가속기 성능을 구현할 수 있도록 지원할 것”이라고 전했다.
권동준 기자 djkwon@etnews.com