AI 시대의 인터넷이 오히려 문을 걸어 잠그기 시작했다. 클라우드플레어(Cloudflare)에 따르면 지난 6월 초 기준 전체 HTML 트래픽의 57%가량이 사람이 아닌 봇에서 발생했다.
클라우드플레어 매튜 프린스 CEO는 봇이 사람보다 많아진 이 같은 현상이 당초 예상보다 1년가량 앞당겨 나타났다고 밝혔다.
클라우드플레어는 지난 1일(현지시간) '콘텐츠 독립기념일(Content Independence Day)'이라는 이름의 새 정책을 발표했다. 크롤러의 목적을 검색·에이전트·학습 세 가지로 구분하고, 오는 9월 15일부터 광고가 포함된 페이지에서는 에이전트·학습 목적 크롤러의 접근을 기본적으로 차단하기로 했다. 검색과 학습·에이전트 기능을 동시에 수행하는 이른바 '혼합형 크롤러'에는 가장 제한적인 규칙이 적용된다. 적용 대상은 신규 고객과 기존 고객의 신규 웹사이트, 무료 요금제 고객 전체다.
클라우드플레어는 동시에 AI 기업에 요금을 부과하는 '페이 퍼 크롤(Pay Per Crawl)' 기능을 '페이 퍼 유스(Pay Per Use)'로 확장한다고 밝혔다. 콘텐츠가 실제로 검색·응답에 활용될 때 비용을 청구하는 방식으로, 세라믹에이아이(Ceramic.ai)·유닷컴(You.com)과 우선 협력한다. 결제 정보 없이 접속하는 크롤러에는 'HTTP 402(결제 필요)' 응답을 돌려준다.
국내에서도 유사한 움직임이 확인된다. 전자신문 보도에 따르면 네이버는 블로그에서 오픈AI·퍼플렉시티·구글·클로드·메타·애플의 AI 봇 크롤링을 로봇배제표준(robots.txt)으로 차단했고, 카페에서는 아마존·마이크로소프트 빙의 AI 봇까지 추가로 제한했다. 네이버 측은 서비스 안정성을 저해하는 과도한 크롤링을 막기 위한 조치라고 설명했다.
클라우드플레어 레이더 집계에 따르면 AI 크롤러 트래픽의 90%에 가까운 비중이 학습 또는 혼합 목적이며, 실제 이용자 요청에 응답하는 트래픽은 10분의 1에도 못 미친다. 이런 흐름과 맞물려 안티봇(anti-bot) 기술도 행동 패턴 분석, 디바이스 핑거프린팅, 머신러닝을 결합한 다층 방어 체계로 고도화하고 있다는 진단이 나온다. 문제는 이 같은 방어 체계가 악의적 봇뿐 아니라, 가격 모니터링·시장 조사·AI 학습 및 검색용 데이터 수집 등 정상적 목적의 자동화된 웹 데이터 수집까지 함께 걸러낸다는 데 있다.
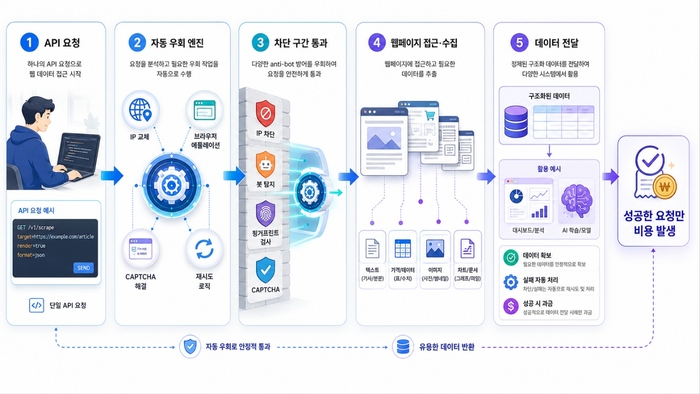
기업 입장에서는 데이터 수집 방식 자체를 다시 설계해야 하는 상황에 놓였다. IP 차단, 캡차(CAPTCHA·자동입력방지시스템), 브라우저 핑거프린트 탐지 등을 사람이 수작업으로 우회하는 방식은 더 이상 지속 가능하지 않다는 진단이 나온다. 이 때문에 웹사이트 접근 자체를 자동화·표준화한 API 형태의 솔루션을 찾는 기업이 늘고 있다.
이런 흐름에서 주목받는 제품 중 하나가 브라이트데이터(Bright Data)의 웹 언라커(Web Unlocker) API다. 이 서비스는 단일 API 호출로 IP 교체, 브라우저 핑거프린트 에뮬레이션, 캡차 해결, 재시도 로직 등을 자동으로 처리해 차단된 웹페이지에 접근할 수 있도록 지원한다. 요청이 실제로 성공해 데이터가 전달된 경우에만 비용이 청구되는 방식이어서, 차단으로 인한 실패 비용을 별도로 부담하지 않아도 된다는 점이 특징이다. 아카마이 봇 매니저(Akamai Bot Manager), 에이치캡차(hCaptcha), 클라우드플레어 턴스타일 등 주요 안티봇·캡차 시스템에 대응하도록 설계됐다는 게 회사 측 설명이다.
다만 전문가들은 낙관은 이르다고 본다. 페이 퍼 크롤 방식이 자리 잡으려면 크롤러가 전자서명 기반의 '웹봇 인증(Web Bot Auth)'을 채택해야 하는데, 주요 AI 기업 상당수는 아직 이를 도입하지 않은 것으로 알려졌다. 웹 크롤링을 둘러싼 법적 회색지대도 당분간 이어질 전망이어서, 기업들이 데이터 접근 전략을 세울 때 컴플라이언스(규정 준수)와 기술적 안정성을 함께 고려해야 한다는 조언이 나온다.
임민지 기자 minzi56@etnews.com