글루시스(대표 박성순)는 최근 열린 한국슈퍼컴퓨팅컨퍼런스(KSC)에서 GPU 대기시간과 반복 연산을 줄이기 위한 차세대 AI 스토리지 기술 전략과 실증 결과를 공개했다고 15일 밝혔다.
고성능 GPU를 대규모로 확보하더라도 데이터 공급이 지연되거나 이미 수행한 계산을 반복하면 GPU 자원을 충분히 활용하기 어렵다.
글루시스는 이에 따라 AI 스토리지를 GPU 뒤에서 데이터를 보관하는 장치가 아니라 AI 작업의 특성과 데이터 생명주기를 이해하는 데이터 인프라로 확장해야 한다고 강조했다.
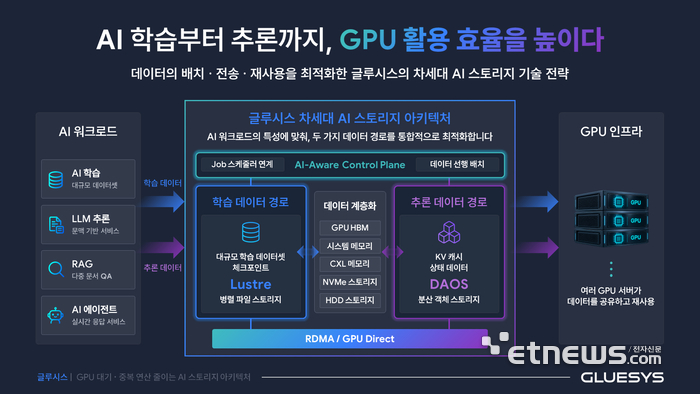
구체적으로 AI 스케줄러의 작업 실행 정보를 활용해 필요한 데이터를 고속 NVMe 영역에 사전 배치하고, 작업 종료 이후에는 데이터의 재사용 가능성에 따라 데이터를 유지하거나 용량 계층으로 이동시키는 방식을 제시했다.
모든 데이터를 고가의 NVMe SSD에 상주시킬 필요 없이 GPU가 실제 사용할 데이터를 필요한 시점에 고속 영역으로 배치해 데이터 로딩 대기시간과 스토리지 비용 부담을 함께 줄이는 것이 골자다.
또 작업별 입출력(I/O) 이력과 스토리지 부하를 분석해 여러 스토리지 노드에 데이터를 분산 배치하고, 특정 장치나 경로에 부하가 집중되는 것을 완화하는 방안도 제시했다.
이를 통해 스토리지는 단순히 용량을 제공하는 인프라에서 한 단계 더 나아가 AI 작업의 실행 흐름에 맞춰 데이터 위치와 자원을 조정하는 소프트웨어 계층으로 역할을 확대할 수 있다는 설명이다.
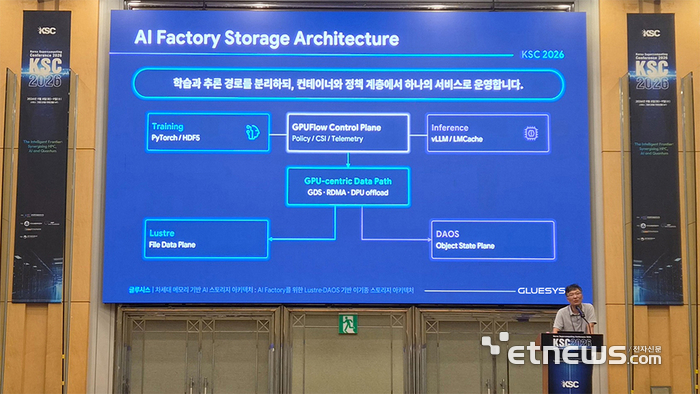
회사는 또 학습과 추론의 서로 다른 입출력 특성에 맞춰 데이터 경로를 분리하는 구조를 제안했다. 대규모 학습 데이터셋과 체크포인트는 Lustre 기반 병렬 파일 데이터 경로(File Data Plane)를 적용하고, LLM 추론 과정에서 생성되는 KV 캐시와 상태 데이터는 DAOS 기반 분산 객체 데이터 경로(Object State Plane)를 적용하는 방식이다.
특히 LLM이 긴 입력 문맥을 처리하면서 생성하는 KV 캐시를 여러 GPU 서버가 공유·재사용하는 구조를 소개했다. 동일하거나 유사한 문맥을 다시 처리할 때 기존 KV 캐시를 활용하면 GPU가 전체 문맥을 처음부터 재계산하는 부담을 줄일 수 있다.
글루시스는 관련 구조의 가능성을 실제 LLM 추론 환경에서도 검증했다고 소개했다. 약 100GB 규모의 공유 KV 캐시와 12개 동시 요청을 구성한 다중 문서 질의응답 실험에서 DAOS 기반 구성의 평균 첫 토큰 응답시간(TTFT)은 216밀리초로 측정됐으며, 동일 조건의 로컬 NVMe SSD RAID 구성은 1074밀리초를 기록했다.
글루시스는 이번 결과가 단순한 저장장치 자체의 속도 차이가 아니라 KV 캐시 재사용과 다중 요청의 병렬 처리, 네트워크 및 스토리지 전송 경로 등 전체 소프트웨어 데이터 경로의 차이에서 나타난 것이라며, 향후 RAG, 다중 문서 질의응답, AI 에이전트 등 동일한 대규모 문맥(Context)을 여러 사용자와 GPU가 반복적으로 활용하는 AI 서비스에서 활용 가능성이 높을 것으로 기대했다.
연구는 과학기술정보통신부 및 정보통신기획평가원(IITP)의 지원을 받아 'AI 연산에 특화된 데이터 경로 최적화 초고대역폭 병렬 스토리지 SW 솔루션 개발' 과제의 일환으로 수행됐다.
글루시스 관계자는 “AI 인프라의 투자 효과를 높이려면 GPU가 데이터를 기다리는 시간과 같은 계산을 반복하는 부담을 함께 줄여야 한다”며 “글로벌 AI·HPC 생태계와 호환되는 데이터 경로 기술을 기반으로 고객이 기존 AI 인프라를 활용하면서 학습과 추론 성능을 단계적으로 높일 수 있는 AI 스토리지 플랫폼을 제공하겠다”고 말했다.
윤건일 기자 benyun@etnews.com