엔비디아가 그래픽처리장치(GPU)와 중앙처리장치(CPU)를 단일 칩으로 결합한 'RTX 스파크(RTX Spark)'를 앞세워 클라우드 연결 없이 개인용 PC에서 인공지능(AI) 비서를 직접 구동하는 '로컬 AI' 시장 공략에 본격적으로 나섰다.
하드웨어 슈퍼칩과 함께 메모리 사용량을 대폭 줄인 경량 모델, 로컬·클라우드 하이브리드 기술을 동시에 선보이며 온디바이스 AI 생태계를 완성한다는 전략이다.
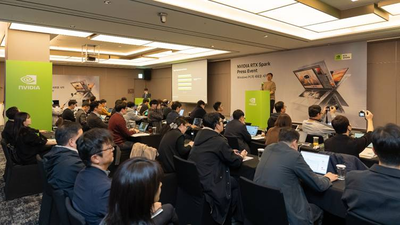
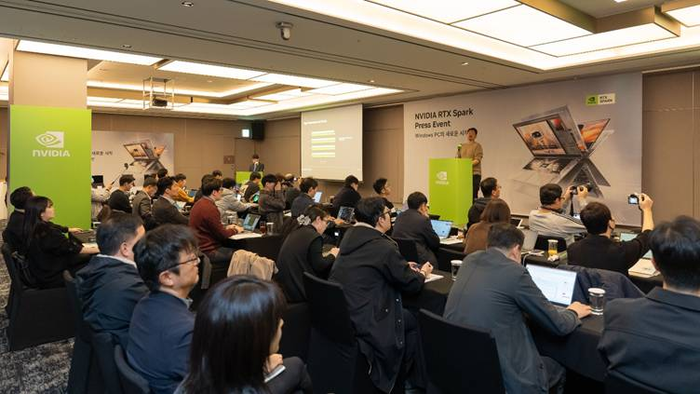
엔비디아는 6일 서울 종로구 JW 메리어트 동대문 스퀘어 호텔에서 '엔비디아 RTX 스파크 기자간담회'를 열고 제품의 핵심 기술 구조와 로컬 AI 에이전트 활용 사례를 공개했다. 지난 6월 젠슨 황 엔비디아 최고경영자(CEO)가 한국에 처음 소개한 RTX 스파크는 지난달 16일 서울 코엑스 출시 행사를 기점으로 국내 정식 판매에 돌입했다.
이날 발표자로 나선 제프 옌 엔비디아 아시아태평양(APAC) 테크니컬 마케팅 디렉터는 “올해는 로컬 에이전트의 해라고 부를 만한 중요한 변곡점”이라며 “로컬 에이전트의 지능이 클라우드 기반 프론티어 모델을 빠르게 따라잡고 있다”고 진단했다.
그는 “기존 대규모언어모델(LLM) 챗봇과 달리 AI 에이전트는 사용자의 목표를 이해하고 추론해 실제 행동까지 수행한다”며 “PC가 단순한 도구를 넘어 함께 일하는 팀원으로 진화하고 있다”고 강조했다.
이 같은 로컬 AI 워크로드를 뒷받침하기 위해 설계된 'RTX 스파크(N1X)'는 엔비디아 블랙웰(Blackwell) RTX GPU와 미디어텍이 공동 설계한 20코어 그레이스(Grace) CPU를 하나의 슈퍼칩으로 묶은 플랫폼이다. 두 칩은 엔비디아의 고속 칩 간 연결 기술인 'NV링크 C2C(NVLink-C2C)'로 연결돼 최대 128GB의 통합 메모리와 1페타플롭(PetaFLOPS) 규모의 AI 컴퓨팅 성능을 지원한다.
기존 노트북은 그래픽 메모리 용량이 GPU 등급에 제한됐으나, RTX 스파크는 CPU와 GPU가 동일한 메모리 공간을 공유하며 캐시 사본을 일치시키는 구조를 채택했다. 이를 통해 대형 AI 모델 구동과 고사양 창작 작업을 하나의 메모리 공간에서 동시에 처리할 수 있으며, 쿠다(CUDA)·DLSS·텐서RT(TensorRT) 등 기존 지포스 RTX 기술 스택도 그대로 지원한다.
엔비디아에 따르면 RTX 스파크는 로컬 에이전트 구동, 미세조정(파인튜닝), 3D 렌더링, 이미지·영상 생성, 게이밍 등 주요 작업에서 일반 시스템온칩(SoC) 대비 2.7배에서 최대 4.6배 높은 성능을 기록했다. 옌 디렉터는 “성능과 전력 효율 면에서 이에 근접한 윈도우 SoC는 없다”고 자신감을 보였다.
이형두 기자 dudu@etnews.com