카카오가 고해상도 이미지와 문서·문자 인식에 특화한 자체 비전 인코더 2종을 오픈소스로 공개하면서 멀티모달 인공지능(AI) 경쟁력을 강화한다.
카카오는 자체 개발한 비전 인코더 'Kanana-2-vision-encoder' 2종을 허깅페이스에 오픈소스로 공개했다고 21일 밝혔다.
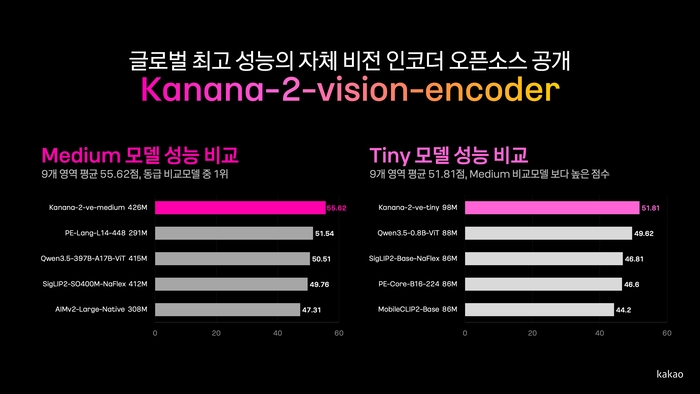
이번에 공개한 카나나 비전 인코더는 4억2600만개 파라미터 규모의 '미디움(medium)'과 9800만개 파라미터 규모의 '타이니(tiny)'다. 카카오는 지난 13일 열린 '이프 카카오(if(kakao)26)' 키노트에서 비전 인코더의 오픈소스 공개를 예고한 바 있다.
비전 인코더는 AI가 이미지를 이해하도록 돕는 '눈' 역할을 하는 기술이다. 이미지 속 사물이나 글자, 위치, 형태 등 시각 특징을 추출해 언어모델에 전달하면 언어모델은 이를 이용자 질문과 함께 해석해 답변을 생성한다. 메뉴판 음식과 가격을 읽거나 문서 내용과 배치를 파악하고, 사진 속 상황을 설명하는 데 활용된다. 이미지 정보를 얼마나 정확하고 세밀하게 포착하느냐는 멀티모달 AI의 답변 품질을 좌우한다.
카카오는 일반 시각 질의응답, 영어 문자 인식·문서 이해, 한국어 문자 인식·문서 이해, 이미지 내 위치 파악·세밀한 인식 등을 포함한 9개 영역, 총 42개 벤치마크에서 카나나 비전 인코더 성능을 평가했다.
카카오 자체 평가 결과 두 모델은 구글의 '시그립(SigLIP)2', 메타의 '퍼셉션 인코더(Perception Encoder)', 애플의 'AIMv2', 알리바바의 '큐웬(Qwen)3.5-ViT' 등 주요 비전 인코더보다 높은 성능을 기록했다.
특히 타이니 모델은 파라미터 수가 1억개 미만인 경량 모델이지만 4억개 이상 규모 일부 글로벌 모델과 비교해서도 높은 성능을 보였다. 이미지 내 위치 파악과 한국어 시험, 한국어 문자 인식·문서 이해 영역에서 상대적으로 큰 성능 차이를 보였다.
카카오는 자체 학습 기술로 작은 글자와 복잡한 문서 구조의 세밀한 시각 정보를 보존해 문자 인식(OCR)과 문서 이해 성능을 높였다고 설명했다.
카카오는 자체 개발한 'Kanana-2' 언어모델을 활용해 비전 인코더의 학습 효율을 기존 대비 약 4배 높였다. 언어모델 성능 향상을 비전 인코더 학습에 활용하는 구조를 구축했다. 고해상도 이미지 처리에 최적화된 설계로 주요 글로벌 비전 인코더 대비 처리 지연 시간을 60% 이상 줄였다. 지식 증류와 경량화 기술도 적용해 미디움 모델부터 온디바이스 활용을 고려한 타이니 모델까지 개발했다.
카카오는 두 모델을 연구·개발뿐 아니라 상업적으로도 활용할 수 있는 '카나나 오픈 라이선스'로 공개한다.
노병석 카카오 유니파이드 파운데이션 모델 성과리더는 “최근 에이전틱 AI 시대를 맞아 PC나 모바일 화면을 직접 이해하고 조작하는 '컴퓨터 유즈' 기술이 주목받으면서 고해상도 이미지를 정확하게 분석하는 비전 인코더 역할이 커지고 있다”면서 “앞으로도 자체 AI 모델 경쟁력을 꾸준히 높이고 관련 기술을 공개해 AI 생태계 발전에 기여하겠다”고 말했다.
변상근 기자 sgbyun@etnews.com